Generation of images with a neuroevolutionary algorithm

Thanks to my recently adquired knowledge about how to display stuff on screen with OpenGL, I have implemented in Python an experiment that years ago I wrote in Java: an algorithm that generates images through the NEAT neuroevolutionary method invented in the mid 2000s. When I implemented it in Java, I had to write the NEAT method from zero by reading the scientific papers, because the Java libraries that existed back then didn’t inspire me much confidence. Fortunately, these days and in Python there are a couple solid modules that free me from that responsibility.

I’ll start showing a six minute video that shows some images generated through a few independent evolutionary processes:

A curious phenomenon, although logical, of the results of the programmed neuroevolution mimics what happens in natural evolution: when some pattern appears close to the beginning of the evolutionary run, and for some reason it benefits the genome, the pattern tends to persist for the rest of the evolution in some form or another (for example, the spinal cord).

The experiment works the following way: it generates a population of around 100 genomes that contains the nodes and connections of a neural network. When it gets activated, it will receive two inputs: the x coordinate divided by the width of the resolution the future image will have, and the y coordinate divided by the height of the future image. After the internal calculation, the neural network will produce the four components of a RGBA color: the value for red, for green, for blue, and for the transparency.

When I implemented this experiment for the first time in Java years ago, I programmed it so that each generation’s genome would produce a 32×32 pixels image, that it saved in the hard disk. I had to choose by hand which interested me and add them to a special folder, from which the program would sample to produce the next evolutionary run. However, even then I realized that I was sacrificing vital information so that seeded evolution would work entirely as expected: the genomes hold information about when its nodes and connections appeared for the first time, along with to what species the genomes belong. That information is vital when the genomes reproduce. This time I intended to solve the issue as soon as possible for the Python version, but I ended concluding that I shouldn’t only save the wanted genomes, but all the species involved in that run, along with the generation number. So it made sense to allow the user to save the entire evolutionary state at the chosen stage, all the genomes and the species they belong to. The equivalent to saving the game and reloading it.

The code draws on the screen a 32×32 version of the image each genome produces. In opposition to my previous implementation in Java, in which the genomes got promoted according to how novel they were, now the user has the responsibility to select the genomes he wants to promote. When he decides to move to the next generation, the algorithm scores the genomes in descending order of selection.

I’ve recorded 100 generations of the process in the following video:

The genomes start either completely disconnected or partially connected to the end nodes; I’ve configured it so a possibility of 10% exists so each connection is present at the beginning. That causes some genomes to output no color, or to come out completely black. However, even in the first generation different patterns are already present: vertical bars, diagonals with distorsions, and gradients. It takes just five generations for three genomes to connect with the green output node. However, curiously, it’s only in the 26th generation when a genome connects with the blue output node. A mix of both dominates the evolutionary run, and there’s a complete, or almost complete absence of connections to the red output.

The neural network that the genome converts to must be executed 32 * 32 times (1024 times) only to generate the texture that I’ll display on screen, so it wasn’t feasible during the recording of the video to generate the full images that I include separately in other videos, because the resolution of 1080×1080 implies executing the neural network for each of the selected genomes 1,166,400 times, which takes a while, and for now I haven’t managed to parallelize it (the overhead kills it).

Although the images generated during the recorded evolutionary run didn’t interest me that much, I’ve gathered some of them in the following video:

UPDATE: I’ve managed to parallelize both generating the pixels for all 100 pictures that get displayed on screen for each generation, as well as saving in the background the selected genomes in full. During the last few months I’ve searched for the right parallelization library written in Python, and after considering Pathos for a while, I’ve settled on the brilliant Dask (https://dask.org/), which makes it very transparent.

This is all it takes to map the generation of the pixels for a population and gather the results:

parallelism1.PNG

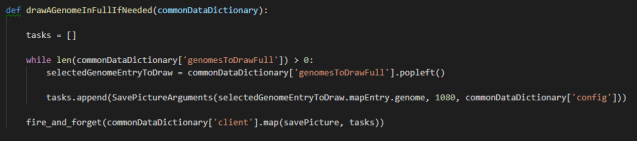
For saving the full pictures, I love the “fire and forget” feature, that allows you to keep advancing the generations while the other cores handle saving the full pictures for the previously selected genomes:
parallelism2.PNG

From here I’ll move on to parallelize certain tasks of my main “experiment”, that game thing: running the behavior trees as well as launching the pathfinding queries.

Generación de imágenes mediante un algoritmo neuroevolutivo

Gracias a mi recientemente adquirido conocimiento sobre cómo mostrar cosas en la pantalla mediante OpenGL, he vuelto a implementar en Python un experimento que hace años implementé en Java: un algoritmo que genera imágenes mediante el método de neuroevolución NEAT inventado a mediados de los 2000s. Cuando lo implementé en Java, tuve que programar el método NEAT desde cero tirando de los artículos científicos, porque las librerías de Java existentes en ese momento no me inspiraban mucha confianza. Por fortuna hoy en día y en Python existen un par de paquetes muy sólidos que me libran de esa responsabilidad.

Empiezo enseñando un vídeo de seis minutos que muestra imágenes generadas a lo largo de varios procesos evolutivos independientes:

Un fenómeno curioso, aunque lógico, de los resultados de la neuroevolución programada se asemeja a lo que pasa en la natural: cuando algún patrón surge cerca del comienzo de la evolución, y por un motivo u otro beneficia al genoma, tiende a perpetuarse durante el resto de la evolución en diferentes formas (por ejemplo, la columna vertebral en los seres vivos).

El experimento funciona de la siguiente manera: se genera una población de unos 100 genomas que contienen los nodos y las conexiones de una red neural. Cuando se necesite activarla, se le pasarán dos valores: la coordenada x dividida entre la anchura de la resolución que la imagen tendrá, y la coordenada y dividida entre la altura de la resolución que la imagen tendrá. Tras el cálculo interno, la red neural produce los cuatro componentes de un color RGBA: el valor para el rojo, para el verde, para el azul, y para la transparencia.

Cuando implementé este experimento por primera vez en Java hace años, yo programé que cada genoma de cada generación produjera una imagen de 32 por 32 píxeles que guardaba en el disco duro. Yo tendría que elegir a mano cuáles me interesaran y añadirlos a otra carpeta, de los que el programa leería al iniciarse la siguiente vez, y sólo consideraría esos genomas elegidos para comenzar otra evolución. Sin embargo, aun entonces yo sabía que estaba sacrificando información vital para que la segunda evolución con genomas anteriores funcionara de la manera adecuada: los genomas guardan información sobre cuándo surgieron por primera vez sus nodos y conexiones, además de a qué especie pertenecen. Ambas informaciones son vitales cuando los genomas se reproducen. Por aquel entonces a mí no se me ocurría cómo implementarlo adecuadamente. En esta ocasión me planteé solucionarlo lo antes posible para la nueva versión en Python, pero acabé llegando a la conclusión de que no sólo habría que guardar los genomas queridos, sino también todas las especies y la generación a la que pertenecen, así que he optado por permitir que el usuario salve una generación entera, todos los genomas y las especies a los que pertenecen. Es el equivalente de salvar la partida y volver a cargarla.

Además, el código dibuja en la pantalla la imagen en 32×32 píxeles que cada genoma produce. Al revés que en mi pasada implementación en Java, en la que los genomas se promovían dependiendo de lo novedosos que fueran, ahora se le da la responsabilidad al usuario de seleccionar los genomas que quiere promover en la evolución. Cuando decida pasar a la siguiente generación, el algoritmo puntua de manera descendiente dependiendo del orden en el que el usuario ha seleccionado los genomas.

He grabado 100 generaciones de este proceso en el siguiente vídeo:

Los genomas empiezan o completamente desconectados o parcialmente conectados a los nodos de salida; lo he configurado para que exista una posibilidad del 10% de que cada conexión esté presente nada más empezar. Eso hace que algunos genomas no produzcan ningún color, o que salgan completamente negros. Sin embargo, en la primera generación ya se presentan patrones diferentes: barras verticales, diagonales con distorsiones, y gradientes. Sólo transcurren cinco generaciones hasta que tres genomas conectan con el nodo de salida verde. Sin embargo, de manera curiosa, es sólo en la generación 26 cuando un genoma conecta con el nodo de salida azul. Una mezcla de ambos acaba dominando la evolución, y faltan por entero, o casi, genomas que contemplen la salida roja.

Dado que la red neural que un genoma forma debe ejecutarse 32 * 32 veces (1024 veces) sólo para generar la textura que luego plasmo en la pantalla, no era factible generar durante la grabación las imágenes grandes que incluyo en los otros vídeos, ya que la resolución de 1080 por 1080 píxeles implica ejecutar la red neural de cada genoma 1.166.400 veces, lo que tarda un buen rato, y de momento no he conseguido paralelizarlo.

Aunque las imágenes generadas durante esa evolución no me han interesado demasiado, he recogido unas cuántas de ellas en el siguiente vídeo:

Experimento sobre búsqueda de ruta en 3D y para personajes con diferentes reglas de movimiento

Pretendo programar un juego de construcción de colonias similar a Dwarf Fortress. Desde el principio supe que debía arreglármelas primero para que el sistema calculara las rutas de los agentes de manera fiable, aprovechando los diferentes hilos del procesador, y que generara rutas adecuadas para agentes que pudieran andar, volar, nadar en aguas poco profundas, en aguas profundas, o una combinación de cualquiera de esas posibilidades.

Hace un par de semanas programé una versión sólida de un generador de mapas locales basado en el ruido Perlin. El vídeo recoge el resultado. Ninguna inteligencia artificial involucrada: el personaje lo muevo yo con el teclado numérico.

Sin embargo, tras varios experimentos en los que yo no tenía claro desde un principio cómo proceder, la arquitectura se había vuelto engorrosa. Dediqué varios días a refactorizar la mayoría del código e implementar nuevas clases que representaban abstracciones que antes ni siquiera existían. El bucle actual consiste en lo siguiente:

  • Una clase llamada Inputs gestiona si el usuario ha presionado alguna tecla, ha movido el ratón o pulsado alguno de sus botones. El sistema ejecuta las funciones dependiendo de las relaciones escritas en un archivo json.inputsMapping.png
  • Una clase llamada Display encapsula todo lo relacionado con dibujar los elementos en la pantalla. Aparte de que aislar esas responsabilidades mejora la arquitectura, ya empezaba a ver que pygame se quedaba corto incluso para dibujar el mapa a una velocidad consistente. Pronto deberé averiguar si puedo sustituir todas las referencias a pygame con llamadas a OpenGL.displayMapping.png
  • Si el usuario pulsa la tecla punto, se simula un turno. Sabía desde un principio que para programar una simulación compleja tendría que aislarla y limitar la cantidad de veces que se ejecutaría en un segundo, aunque la simulación acabara aprovechando los diferentes núcleos del procesador.
  • Durante la simulación de un turno, una clase Messenger, encargada de publicar mensajes a su subscriptores, envía el mensaje de update para que todas las clases que deban hacerlo ejecuten su lógica de actualización. Para encapsular este comportamiento tuve que reestructurar por completo cómo representaba una entidad en el programa. Aunque ya conocía la tendencia moderna de representar entidades mediante componentes en vez de como jerarquías de herencias, consideré que para los experimentos simples del principio bastaba con heredar de clases simples como Actor y Personaje. Había programado las casillas del mapa como entidades aparte, pero la necesidad de todos esos objetos de actualizarse y mostrarse en la pantalla evidenciaba que necesitaba reducir la idea de cada entidad a un identificador (en este caso, un UUID), y que una multitud de componentes independientes se encargaran de su funcionalidad. Programé el sistema para que bastara con definir los componentes de cada entidad en un archivo de texto json. Una serie de constructores y factorías compondrían una entidad cuando fuera necesario.

entities.png

  • Una clase llamada ComponentManager se encarga de archivar la relación de identificador y componente en un diccionario. Permite recuperar cualquier componente existente de un identificador concreto sin involucrar al resto de componentes.

componentManager.png

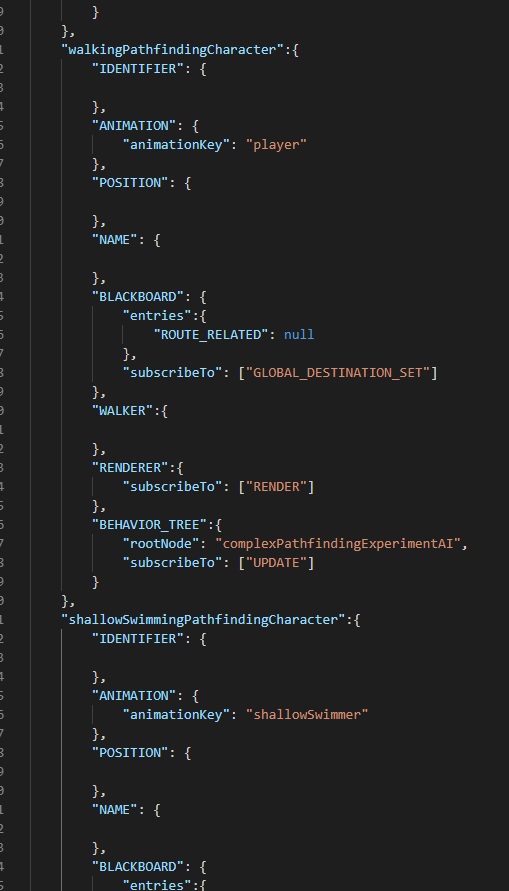
  • Una clase de componentes que reciben el mensaje para actualizarse son los Behavior trees, o árboles de comportamiento. La inteligencia artificial para los agentes modernos se ha reducido a estos árboles o a planning systems (sistemas de planificado), sobre los que no he leído todavía. Pero los árboles de comportamiento encajan de maravilla con la neuroevolución. Algunos de los nodos de un árbol de comportamiento se limitan a decidir qué comportamiento se ejecutará, así que bastaría con crear nodos específicos que cumplieran esa función mediante redes neurales evolucionadas. Los árboles de comportamiento son enrevesados, y a pesar de su aparente simplicidad, decidir su estructura para que reflejen el comportamiento exacto que quieres puede complicarse bastante. Para empezar, decidí que bastara con definir un comportamiento aislado en un archivo json. Una serie de constructores y factorías crearía la red final de objetos. La siguiente es la definición de la inteligencia artificial completa que permite a cada uno de los agentes del siguiente vídeo moverse:

moveToBT.png

  • Refleja el siguiente esquema:

Move_to_destination Behavior.jpg

  • La mayoría de los libros y artículos sobre árboles de comportamiento recomiendan reducir su composición a los selectores básicos: sequencias y fallbacks (o selectores clásicos), aparte de decoradores. La sequencia funciona de la siguiente manera: si el primer hijo falla, la sequencia entera falla y envía el fallo al nivel superior. Si todos sus hijos devuelven que han satisfecho su tarea, la sequencia se considera satisfecha. Los fallback funcionan al revés: si un hijo falla, se prueba el siguiente. Si todos fallan, el fallback falla, pero si alguno de los hijos ha satisfecho su tarea, el fallback se considera satisfecho. Aunque me devané los sesos para componer el árbol de manera que no necesitara repetir ningún nodo, no lo conseguí. Como el diagrama refleja, la lógica considera dos veces si el agente ha terminado de calcular su ruta, y otras dos veces si puede moverse al siguiente punto de la ruta. Pero funciona como está.
  • Este comportamiento tiene poco de inteligente, claro. Sólo refleja una secuencia lógica de acciones para pedir un cálculo de ruta, asegurarse de que haya terminado de calcularse, consumirla y determinar si el agente ha alcanzado su destino. Pero la estructura está dispuesta para implementar comportamientos mucho más complicados.
  • En un principio pretendí ejecutar los árboles de comportamiento en diferentes hilos o procesos, para aliviar el núcleo principal del procesador. Sin embargo, Python es muy peculiar a la hora de tratar los hilos, y para ejecutar cada árbol de comportamiento en un núcleo diferente, el sistema copiaría todo el árbol y las clases involucradas. Si la estructura se limitara a la lógica, no habría mucho problema, pero muchos de esos nodos deben preguntar cosas a diferentes componentes de la entidad, lo que implica tener que copiar el diccionario entero de comportamientos. Podría arreglármelas para aislarlo, pero en el futuro es de esperar que alguno de los nodos debiera mirar dentro del mapa, lo que implicaría copiar el mapa entero a otro proceso. Demasiado pronto para decidirme.
  • Lo que sí implementé fue separar la idea de razonar de la de ejecutar el razonamiento. Los árboles de comportamiento sólo devuelven tareas a ejecutar, y no se encargan de modificar el mundo ni los actores. Cada turno, otra clase dedicada a almacenar tareas y procesarlas las ejecuta como considere oportuno, ya sea en el mismo núcleo o en los hilos disponibles. En el futuro también debería ejecutar tareas en otros procesadores.

tasksScheduler.png

  • Mencionaré que aunque había implementado el algoritmo A* de búsqueda de ruta hace unas semanas, no encontré la manera de incorporar las reglas de movimiento en él, así que tuve que programarlo otra vez desde cero siguiendo otro ejemplo. Pero la versión actual es mucho mejor, y refleja las reglas de movimiento perfectamente.
  • De momento sólo ejecuta fuera del hilo principal los cálculos de ruta, y únicamente en los hilos disponibles. Mis primeros intentos por implementar mediante el multiproceso la búsqueda de ruta fueron descorazonadores: tardaba al menos tres o cuatro segundos en devolver incluso las rutas vacías. No acababa de verle el sentido, pero se debía a que no entendía la diferencia entre hilos y procesos. Los hilos existen en un proceso y usan el mismo espacio de memoria. Pueden acceder a los datos. Si uno de ellos escribe un dato mientras otro hilo intenta leerlo, se producirán inconsistencias, pero para evitar ese problema basta con dividir la ejecución interna de los efectos externos. Sin embargo, yo mandaba calcular la ruta mediante un pool de procesos, para lo que el ordenador debía iniciar el Python en otro núcleo del procesador y copiar todos los datos involucrados. Ahora resulta evidente que sólo las tareas que puedan permitirse tardar varios segundos en devolver un resultado se benefician del multiproceso, pero de todas formas son muchas: por ejemplo, si se quiere procesar la temperatura, la presión del aire, etc., de cada casilla del mapa, o calcular un mapa de amenazas o de visibilidad, o procesar qué pasa en el mundo en general mientras el juego transcurre en el mapa local. En el futuro imagino que podría aprovechar el octree del mapa, que distribuye a los agentes según su cercanía, para ejecutar la inteligencia de los agentes cercanos en hilos, pero procesar la de los demás en otros procesadores.
  • Algunas tareas producen comandos: acciones que modifican a algunos agentes y/o el mapa. En este caso producen la acción de moverse al siguiente punto de su ruta. Como se verá en el vídeo, también gestiona si el siguiente punto de la ruta está bloqueado por otro agente, y en ese caso permitirá volver a buscar una ruta otro par de veces antes de renunciar a ese destino. Una clase se encarga de procesar la cola de comandos ejecutándolos uno tras otro.

El experimento tenía una complejidad añadida: yo quería que convivieran agentes que andaran por el suelo con otros que volaran, nadaran en aguas poco profundas, en profundas, etc. En vistas al futuro, el sistema debería permitir añadir comportamientos como por ejemplo los de un agente que se moviera abriendo túneles en los bloques sólidos de roca, o que nadara en lava. Además, esas capacidades de movimiento deberían poder combinarse: algunos agentes deberían poder volar, nadar y además abrir túneles en roca, por ejemplo. Para ello tuve que abstraer las reglas de movimiento a archivos json.

movementRules.png

La búsqueda de ruta necesitaba conocer las posibles casillas vecinas de cada casilla que consideraba. La accesibilidad de cada casilla dependía del agente que pedía la ruta, así que en un primer momento no se me ocurría otra cosa que calcular los vecinos cada vez que se pedía calcular una ruta. Eso ralentizaba mucho la búsqueda, obviamente. Al final opté por generar cada posible vecino en un diccionario interno del mapa, poco después de generarse al comienzo del experimento. Eso tarda unos ocho segundos, pero no necesitará volver a hacerlo durante el transcurso del experimento o del juego salvo que alguna casilla cambie, y aun así sólo deberán recalcularse los vecinos inmediatos de la casilla que haya cambiado. Esa tarea se puede delegar a un hilo aparte.

Sin embargo, la lógica que genera los vecinos de cada casilla es de lo más complicado que he programado recientemente:

neighbors.png

El resultado se ve en el siguiente vídeo. Hay cuatro tipos diferentes de agentes. Unos andan, y sólo pueden moverse por la tierra (aunque podría incluir sin problemas que nadaran en aguas poco profundas). Otros vuelan, lo que implica que pueden moverse por el aire y por la tierra. Otro agente sólo nada por aguas poco profundas. El último agente nada por aguas poco profundas y por las profundas.

Cuando todo funcionaba ya, he cambiado un par de detalles de la implementación. La búsqueda de ruta se ejecuta en hilos; aunque los hilos funcionan de manera semiindependiente, si a una búsqueda le costaba encontrar el camino, bloqueaba el sistema durante un segundo o algo más. Las búsquedas normales consideran unas veinte, treinta o cincuenta casillas. Algunas raras superan las cien. Pero esas búsquedas que bloqueaban el sistema consideraban hasta mil quinientas o más. Acabé limitando artificialmente la consideración de casillas a unas trescientas. Como resultado, algunos agentes no se moverán a ese destino, pero en el transcurso de un juego podría considerarse razonable: el destino es demasiado complicado como para alcanzarlo desde su punto de origen. La inteligencia artificial lo tendría en cuenta y lo derivaría a otras acciones.

Después de esto me toca refactorizar un poco más el sistema para integrar a la arquitectura los bloques más sólidos del experimento, y luego investigaré cómo trabaja Python con OpenGL y si es factible reemplazar pygame por completo.

Implementation of pathfinding with Z levels

The following video shows an actor moving through the different levels of depth of a simple map, and then going for a while to random coordinates on the first level:

Although the actor reaches the objective, for now I haven’t managed to prevent that in two particular moments the actor decides to go through the roof as part of his route, although I had modified the code so it wouldn’t allow him to do so, at least in theory. But it’s a minor problem for what I intended implementing the pathfinding: that when I programmed new experiments in which the user moved his character, around him other actors would find their way and act according to their AI.

Movement in three dimensions tends to divide these kinds of games. Dwarf Fortress is famous in part for how it handles the different layers, allowing the user to strike the earth for a couple dozen levels to build his fortress, or raise it several levels above sea level if he wants to. On the other hand, Rimworld, programmed with Unity, sacrifices that verticality to offer better graphics and effects and a complexity limited in comparison. I was convinced that simple sprites were enough in exchange of a complex simulation and an artificial intelligence that would, hopefully, surprise often. And behave reasonably to begin with.

I programmed this experiment a few days ago, but I recall spending a couple hours trying to solve a problem. When the actor had to find his route to the inside of the house, which should force him to pass through the doorway, the actor went straight to the western wall of the house, his image passed through and stopped in the final coordinates. I was making sure that the pathfinding algorithm identified the wall as impassable, but the actor was still going through it. In the end, after a lot of testing, I revised my assumptions. Were the actor sprites being displayed according to the level they were in? Turns out I had let that for later, and the pathfinding was doing its job: instead of going through the wall, the actor jumped it and “crashed” through the roof to reach his objective. The function that had to draw the actor showed him indistinctly going through a wall that in reality existed a level below.

After that, to make sure the pathfinding algorithm worked better in three dimensions, I had to add more booleans to the tiles. Apart from whether or not they blocked the straight path, they should mark whether they blocked going upwards or downwards (days later I wrote a couple of booleans more: whether the tile blocked the path straight up and down). Otherwise the actor would go through several layers of underground tiles to reach a basement. The changes worked for the most part, shown in the video where the actor goes down the stairs to reach the basement.

To draw the different layers of depth I paid attention to how Dwarf Fortress did it. When the user went up a z level, if any tile was defined as “empty”, the program should draw the closest “real” tile below, but tinted blue to show the user that he was seeing tiles belonging to another z level. On my first try, the code copied each of those sprites and modified its RGB component according to how close they were to the current z level. That’s shown in the video. However, copying all those sprites every frame hurt the framerate too much. A couple of days later I opted for something simpler and that even works better: I draw the first “real” tile normally, but over it I draw translucent tiles for each z level in between. The translucent tiles stack up, darkening the tile below.

This experiment worked for what I intended, so I moved on to new ones.

Implementación de búsqueda de ruta con niveles de profundidad

El siguiente vídeo muestra a un actor moviéndose por los diferentes niveles de profundidad de un mapa simple, y luego dirigiéndose por un rato a puntos aleatorios del primer nivel:

Aunque el actor alcanza su objetivo, no conseguí de momento evitar que en dos puntos concretos decidiera atravesar el techo como parte de su ruta, a pesar de que yo había modificado el código para que en teoría lo evitara. Pero se trata de un problema menor para lo que pretendía implementando la búsqueda de ruta: que en otros experimentos en el que el usuario moviera a su personaje, a su alrededor hubiera actores moviéndose y actuando en base a su inteligencia artificial.

El movimiento en tres dimensiones suele dividir este tipo de juegos. Dwarf Fortress es famoso en parte por cómo gestiona las diferentes capas, permitiendo profundizar en la tierra durante un par de decenas de niveles para construir tu fortaleza, o elevándola varios niveles sobre el nivel del mar si se quiere. En contra, Rimworld, programado con Unity, sacrifica esa verticalidad para ofrecer mejores gráficos y una complejidad muy limitada en comparación con Dwarf Fortress. Yo tenía claro que los sprites en dos dimensiones bastaban a cambio de ofrecer un juego con una simulación compleja y una inteligencia artificial que, con suerte, sorprenda a menudo. Y que actúe de una manera razonable en un primer lugar.

Programé este experimento hace unos pocos días, pero recuerdo que dediqué un par de horas intentando solucionar un problema. Cuando el actor debía encontrar su ruta hasta el interior de la casa, lo que debería obligarlo a pasar por la puerta, dado que se trata de una única entrada despejada, el actor se dirigía al muro occidental de la casa, su imagen pasaba a través del muro y acababa la ruta en su objetivo. Yo me aseguraba de que el algoritmo de búsqueda de ruta identificaba el muro como impasable, pero a pesar de ello lo pasaba. Al final, después de mucho probar, revisé lo que yo había asumido sobre la escena: ¿de verdad los gráficos dibujaban al actor en el nivel de altitud en el que está de verdad? Resultó que había dejado eso para otro momento, y la búsqueda de ruta hacía su trabajo: en vez de atravesar el muro, lo subía y luego atravesaba el techo para llegar a su objetivo. La función que dibuja la escena reflejaba al actor de manera indistinta atravesando el muro que en realidad se encontraba en un nivel por debajo.

A raíz de eso, y de manera previsible, para que el algoritmo de búsqueda de ruta funcionara mejor en tres dimensiones tuve que añadir otros booleanos a cada terreno. Aparte de si bloqueaban el paso a través, debían marcar si bloqueaban subir a un nivel superior, para que a un actor no le diera por elevarse por el cielo, y también debían marcar si bloqueaban lo contrario, bajar a un nivel inferior, para que no atravesaran varias capas de tierra subterránea para llegar a un sótano. La modificación acabó funcionando en su mayor parte, lo que se ve en el vídeo cuando el actor baja por la escalera para alcanzar el sótano.

Para dibujar las diferentes capas de altitud me fijé en cómo lo hacía Dwarf Fortress. Cuando el usuario sube la vista a un nivel superior, si alguna casilla está vacía, el programa debería dibujar lo que está por debajo, pero tintado de otra manera para que no le parezca al usuario que está viendo elementos en la misma dimensión. En un primer lugar el código copiaba cada una de esas casillas inferiores y las tintaba con más o menos azul en función de lo lejos del nivel actual que se encontraban. Eso se ve en el vídeo. Sin embargo, reducía los fotogramas por segundo de una manera bestial. Un par de días después opté por algo más simple y que además funciona mejor: dibujo la casilla original de manera normal, pero luego voy dibujando casillas traslúcidas por cada nivel de altitud que lo separe de la vista. Las transparencias se acumulan y oscurecen la casilla inferior.

El algoritmo me sirve de momento como ha quedado, así que paso a otros experimentos.

(Iteration #2) Simple experiment about neuroevolution

After changing some elements of the experiment, I got the actors behaving in a way closer to what I wanted:

I reestructured the inputs, the sensorial information, that each of the neural networks received. I thought that including so many values that only held the information about where some fruit was located, even if they included the notion of the cardinal direction where it was, destroyed the balance with the rest of the inputs. So I reduced them to the following:

  • A normalized value, from 0.0 to 1.0, that represents each turtle’s health
  • A normalized value, from 0.0 to 1.0, that represents how close is the closest fruit
  • A value of 1.0 if a turtle has another one right next, and 0.0 otherwise

Although I couldn’t think of an obvious way the final input would affect the behavior, it was information present in the simulation, and part of a neural network’s job consists in not using the information that doesn’t help it achieve its objective.

I also added an output: if it received the maximum value, the actor would walk a tile in a random direction. As the video shows, in a few generations those turtles that received the highest values for that single output ended up reproducing more, because moving through the map got them closer to the fruit. They dominated so much that I reduced the amount of fruit present at any given moment, to make sure they weren’t just walking over it randomly. Many of the members of many generations gravitate towards the fruit; after all, the inputs include a measure of how close the closest piece is. I don’t know if the information of whether each turtle had another one right next to them affected anything.

The experiment went well enough for me, and I moved on to more interesting ones.

(Iteración 2) Experimento simple sobre la neuroevolución (NEAT-Python)

Tras cambiar varios elementos del experimento he conseguido un comportamiento de los actores cercano a lo que quería:

Reestructuré los inputs, la información sensorial, que cada una de las redes neurales recibía. Me pareció que incluir tantos valores que sólo recogían información sobre la localización de alguna fruta, aunque incluyera el sentido de en qué dirección cardinal se encontraba, destrozaba el balance con el resto de los inputs. Ahora recibe los siguientes:

  • Un valor normalizado, de 0.0 a 1.0, que representa la salud de cada tortuga
  • Un valor normalizado, de 0.0 a 1.0, de lo cerca que se encuentra la fruta más próxima
  • Un valor de 1.0 si alguna tortuga se encuentra a su lado, 0.0 en caso contrario

Aunque el último input en principio no afectaría de una manera obvia al resultado, se trataba de información presente en la simulación, y el trabajo de una red neural también consiste en no usar información que no la ayude de verdad a conseguir su objetivo.

También añadí un output: si esa salida recibía el valor máximo, el actor daría un paso en una dirección aleatoria. Como se ve en el vídeo, en pocas generaciones esas tortugas que procesaban valores altos para ese único output acabaron reproduciéndose más, ya que moverse por el mapa los acercaba a la fruta presente. Triunfaron tanto, de hecho, que limité la cantidad de fruta para asegurarme de que no topaban con ella por error. En muchas generaciones se ve cómo la mayoría de los agentes gravitan hacia la fruta; a fin de cuentas, los inputs incluyen una medida de lo cerca que se encuentran a la más próxima. No sé si la presencia de otra tortuga junto a otra ha afectado algo.

Considero que el experimento ha salido bien, y he pasado a otros experimentos más interesantes.

Simple experiment about neuroevolution (NEAT-Python)

The next video, that shows about 166 generations of the evolving neural networks, clarifies the situation enough so I can explain myself later:

I’m interested in programming above all because of artificial intelligence and videogames. Although I consider myself a writer first, another one of my dreams, shared with many programmers of modern videogames, consists on making a game with the best of Dwarf Fortress, but with the more immediate and exploratory aspects of games like Cataclysm: Dark Days Ahead. Rimworld’s ambience comes somewhat close to what I would want, but I’d prefer a complexity closer to that of Dwarf Fortress, with most of its elements depending on procedural generation, and supported with an artificial intelligence based on neural networks that would offer constants surprises.

To prove to myself that I could program the visual aspect of a similar game and set the basis for developing the intelligence of its actors, I intended to develop the prototype shown in the video. For now I’ve failed in generating the behaviors that I wanted for the involved neural networks, but having reached this point allows me to progress quickly.

For those who don’t know it, and according to the story as I remember it, neural networks were considered the Holy Grail of artificial intelligence in the eighties and early nineties, but they crashed against an unsolvable problem: no mathematical model could determine which was the best architecture to use for a network to solve a particular problem. They depended on trial and error, and eventually neural networks ended up relegated to obscurity for the most theory-minded and a minority of dedicated programmers.

But in 2002, Kenneth Stanley, from Texas university in Austin, wrote the following paper:

Evolving Neural Networks through Augmenting Topologies

The paper, and those that followed it, revealed the way to solve the main issue with neural networks: instead of designing its architecture, it should evolve through a genetic algorithm. A significant part of the revolution in artificial intelligence we are living in has its origin in papers like this one and others from that era.

The prototype I intended to build had to implement the the following elements:

  • The visual aspect of games like Dwarf Fortress (with tilesets) and Cataclysm: Dark Days Ahead.
  • A reusable architecture that would allow adding new features and programming other experiments easily
  • It would implement the neuroevolution using some library based on NEAT
  • The neural networks should evolve a behavior close to what I intended

Visual representation of a neural network:

neuralnetwork.jpeg

A neuroevolution tends to begin with only the input and output layers set. The inputs represent the sensorial information that a neural network would process, and the outputs the answers that the internal architecture generates through the interaction of all the nodes.

The success of this method depends mainly on the following factors: the inputs must feed the network with the relevant information that could end up producing the intended behavior, and the inputs should be normalized (should be scaled to a range of 0.0 to 1.0). For my experiment I settled on the following inputs:

  1. The normalized value of each turtle’s health
  2. A value of 1.0 if the animal detects a fruit close enough in the northwest, but 0.0 otherwise.
  3. Same but in the north
  4. Same but in the northeast
  5. Same but in the east
  6. Same but in the southeast
  7. Same but in the south
  8. Same but in the southwest
  9. Same but in the west

I decided that each actor would act depending on which output had produced the highest value, and according to its index, the actor would walk a tile over to one of the cardinal directions or it would stay in place.

I chose those inputs because I considered that an actor should learn to link his health deteriorating quickly to the need to search for food, and the actor should detect the fruits instead of stumbling in the dark.

Apart from the architecture of the network, the other key is the function that determines each neural network’s fitness. The fitness is a mathematical measure of how close the network has gotten to the goal. Usually it consists in reaching a high number. In my case I settled for the following function:

((Health ^ 2) + (AmountOfFruitsEaten * 50) + (TurnsSpentNearFood * 2)

I wanted to reward the actors that kept their health as high as possible, and as secundary measures I wanted to suggest that they should look for food and keep close. I’m terrible at math and I’m doing this alone, so suggestions are welcome.

For now the experiment hasn’t produced the behaviors I intended. I’ll leave it some night so it can reach a thousand or thousands of generations, but at least I’m happy that it’s built upon a platform that could allow me to move towards programming something close to an interesting videogame or simulation.

UPDATE: I’ve changed some aspects of the experiments and gotten results close enough to what I intended. I’ll write another post showing them.

Experimento simple sobre la neuroevolución (NEAT-Python)

El siguiente vídeo, que recoge unas 166 generaciones de las redes neurales que evolucionaban, ilustra la situación lo suficiente como para que me explique después:

Me interesa la programación sobre todo por la inteligencia artificial y los videojuegos. Aunque me considero primero un escritor, otro de mis sueños, compartido con muchísimos programadores de videojuegos modernos, era crear un juego que recogiera lo mejor de Dwarf Fortress, pero con los aspectos más inmediatos y exploratorios de juegos como Cataclysm: Dark Days Ahead. La ambientación de Rimworld recoge parte de la idea, pero yo querría una complejidad mucho más cercana a Dwarf Fortress, con la mayor cantidad de elementos basados en la generación procedural, y una inteligencia artificial fundada en las redes neurales que ofreciera sorpresas constantes.

Para probar a mí mismo que podría programar el aspecto visual de un juego semejante y establecer la base para desarrollar las inteligencias de sus actores, pretendí desarrollar el prototipo que se muestra en el vídeo. De momento he fracasado en generar los comportamientos que pretendía para las redes neurales involucradas, pero haber llegado hasta este punto me permite progresar deprisa.

Para quienes lo desconozcan, y de acuerdo con la historia tal como la recuerdo, las redes neurales se consideraban el Santo Grial de la inteligencia artificial en los años ochenta y principios de los noventa, pero se toparon con un problema insalvable entonces: no existía ningún modelo matemático que determinara cuál era la mejor arquitectura de cada red neural para resolver los problemas concretos. Que dependieran del ensayo y error acabó relegando las redes neurales a los ámbitos más teóricos o a una minoría de programadores dedicados.

Pero en 2002, Kenneth Stanley, de la universidad de Texas en Austin, sacó este artículo académico:

Evolving Neural Networks through Augmenting Topologies

El artículo, y los que se sucedieron, revelaron la manera de solventar el problema principal de las redes neurales: en vez de diseñar su arquitectura, debería evolucionar mediante un algoritmo genético. Una parte significativa de la revolución en inteligencia artificial que vivimos durante estos días tiene su origen en este artículo y en otros de esa época.

El prototipo que yo pretendía construir debía implementar los siguientes elementos:

  • El aspecto visual de juegos como Dwarf Fortress (con tilesets) y Cataclysm: Dark Days Ahead
  • Una arquitectura reusable para que tanto añadir nuevos elementos como programar experimentos adicionales fuera razonablemente fácil
  • Implementar la neuroevolución con alguna librería de NEAT
  • Que las redes neurales evolucionaran un comportamiento cercano a lo que quería

Representación visual de una red neural:

neuralnetwork.jpeg

La neuroevolución suele empezar sólo con la capa de inputs y la de outputs. Los inputs representan la información sensorial que una red neural recogería, y el output la respuesta que la arquitectura interna genera mediante la interacción de todos los nodos.

Con respecto a la arquitectura, que una neuroevolución funcione bien depende en gran medida de los siguientes factores: que los inputs recojan la información relevante para generar los comportamientos queridos y que estén bien normalizados (reducirlos proporcionalmente a rangos como de 0.0 a 1.0). Para mi experimento decidí los siguientes inputs:

  1. El valor normalizado de la salud de esa tortuga.
  2. Valor de 1.0 si ve una fruta en el noroeste (en las cuatro casillas más cercanas), 0.0 en caso contrario
  3. Lo mismo pero en el norte
  4. Lo mismo pero en el noreste
  5. Lo mismo pero en el este
  6. Lo mismo pero en el sureste
  7. Lo mismo pero en el sur
  8. Lo mismo pero en el suroeste
  9. Lo mismo pero en el oeste

Decidí que cada actor actuaría en función de qué output había recibido el valor más alto, y dependiendo de cuál se tratara, avanzaría una casilla en una dirección cardinal o se quedaría quieto.

Opté por esos inputs porque consideré que un actor debería aprender a relacionar que su salud se deterioraba rápidamente con la necesidad de buscar comida, y necesitaba poder detectar las frutas para que topar con ellas no fuera una coincidencia.

Aparte de la arquitectura de la red neural, la otra pieza fundamental es la función que determina el fitness de cada red neural. El fitness consiste en un valor que calcula matemáticamente cuánto se ha acercado a cumplir la meta. Por lo general suele consistir en intentar alcanzar un valor alto. En mi caso me decidí por la siguiente función:

((Salud) ^ 2) + (CantidadDeFrutasComidas * 50) + (TurnosPasadosCercaDeFruta * 2)

Quería premiar a los actores que mantuvieran la salud lo más llena posible, pero también pretendía sugerir que debían buscar comida activamente y no alejarse demasiado de ella. Soy pésimo con las matemáticas y programo solo, así que se admiten sugerencias.

De momento el experimento no ha sacado los comportamientos que quería. Lo dejaré alguna noche para que cumpla mil o miles de generaciones, pero al menos me alegra que se sostenga sobre una plataforma que me permitirá avanzar hacia programar algo cercano a un videojuego interesante.